マルチンゲール過程とその性質
確率過程 $\{X(t),t\in T\}$ を特徴付ける重要な側面の1つは、異なる時点間の $X(t)$ の相互関係を明らかにすることである。これまで、2つの異なる時点 $t_1$ と $t_2$ における $X(t_1)$ と $X(t_2)$ の関係を特徴付けるものとして相関係数があることを学んだ。
$\rho=0$ のとき、$X(t_1)$ と $X(t_2)$ は無相関であるという。代数的な観点から言えば、無相関は $X(t_1)\perp X(t_2)$ を意味し、両者の間に線形関係がないことを示すが、他の関数関係が存在しないことを意味するわけではない。
例えば、$X\sim U(-a,a)$、$Y=g(X)$($g$ は偶関数で $E[|Xg(X)|]<\infty$)とすると、$E[X]=0$、$\mathrm{Cov}(X,Y)=E[Xg(X)]=0$ となり $X\perp Y$ であるが、確率変数 $X$ と $Y$ には明確な関数関係がある。
もし $X(t_1)$ と $X(t_2)$ が互いに独立であれば、異なる時点間での値は独自に変化し、いかなる繋がりもないことを意味する。一方で、独立であれば必ず無相関(すなわち $X(t_1)\perp X(t_2)$)である。
しかし、$X(t_1)$ と $X(t_2)$ の間に線形関係がない状態から、両者の値に全く関係がない状態までの間には、まだ多くの空間が存在する。すなわち、$X(t_1)$ と $X(t_2)$ に線形関係がなくても(直交していても)、何らかの関係が存在する可能性があり、このような関係は非常に研究する価値がある。
マルチンゲールおよびセミマルチンゲールは、このような関係を記述する非常に重要な過程のクラスである。マルチンゲール性は多くの問題で発生する関係を表現しており、理論および応用における基本ツールとして、金融工学、通信、環境意思決定などの分野で広く応用されている。金融デリバティブの価格付け、吸収確率の計算、連続時間過程のパス構造の分析、逐次決定や制御モデルの分析などに用いることができる。本章では、関連する基本内容を簡潔に紹介する。
マルチンゲールおよびセミマルチンゲール過程の最も基本的なツールは条件付き期待値であるため、まずは条件付き期待値の性質を振り返る。
条件付き期待値とその性質
第1章で条件付き期待値のいくつかの性質について学んだ。$(X,Y)$ が密度関数を持つ場合、一般的な条件付き期待値は以下のようになる。
すなわち、この数値は $Y$ の実現値 $y$ に関係している。$Y$ は確率変数であるため、固定した値をとらない場合、$E(X|Y)$ も確率変数となる。
例 6.1 $(X,Y)\sim f(x,y)=2I_G(x,y)$、$G=\{x\ge0,y\ge0,x+y\le1\}$ とする。簡単な積分により、$Y$ の周辺分布は
したがって、
よって、$E(X|Y)$ は確率変数の関数であり、一般的な場合でも成立する。すなわち、$E(X|Y)=g(Y)$ と記すことができる。
条件付き期待値は確率変数から確率ベクトルへと一般化できる。$(X,Y_1,\dots,Y_n)\sim f(x,y_1,\dots,y_n)$、$(Y_1,\dots,Y_n)\sim f_2(y_1,\dots,y_n)$、$E|X|<\infty$ とする。このとき、$Y_i=y_i \ (i=1,\dots,n)$ が与えられた下での確率変数 $X$ の条件付き密度関数は以下のようになる。
これより、以下の定義を得る。
定義 6.1 確率ベクトル $(Y_1,\dots,Y_n)=(y_1,\dots,y_n)$ が与えられた下での、確率変数 $X$ の条件付き期待値は次のように定義される。
この値は $(y_1,\dots,y_n)$ に依存する。$(Y_1,\dots,Y_n)$ は確率ベクトルであるため、その実現値が指定されていない場合、式((180))は確率ベクトル $(Y_1,\dots,Y_n)$ の関数であり、通常以下のように表される。
系 6.1 条件付き期待値の定義において、$(X,Y_1,\dots,Y_n)$ が同時密度関数を持つことは必ずしも要求されず、$E|X|<\infty$ であればよい。
系 6.2 条件付き期待値における「条件」は一般に情報として理解できる。すなわち、情報は確率ベクトル $Y_1,\dots,Y_n$ を通じて表現され、条件付き期待値はこれらの情報を知った下での $X$ の平均値を意味する。
命題1.1より、以下の条件付き期待値の性質をさらに導くことができる。
- $E\{E(X|Y_1,\dots,Y_n)\} = EX$。ここで最初の期待値は確率ベクトル $Y_1,\dots,Y_n$ に関する期待値である。
- $X$ と $Y_1,\dots,Y_n$ が独立であるならば、
$$E(X|Y_1,\dots,Y_n) = EX\tag{182}$$すなわち、条件付き期待値と無条件期待値は等しい。直感的に言えば、$X$ をある株式市場の収益率とした場合、情報 $Y_1,\dots,Y_n$ が $X$ と無関係であれば、その情報を持っていたとしても収益率の理解には役立たず、平均値に影響は及ばない。
- $E(X|Y_1) = E[E(X|Y_1,Y_2)|Y_1] = E[E(X|Y_1)|Y_1,Y_2]$。
これは条件付き期待値の平滑化の性質の拡張であり、情報 $Y_1$ の下での条件付き平均が2段階に分けて計算できることを示している。第一段階で $Y_1, Y_2$ の情報の下で条件付き平均をとり、第二段階でさらに $Y_1$ の情報に基づき平均をとる。2つ目の等式は、$E(X|Y_1)$ を知った後で、情報 $Y_1, Y_2$ に基づき条件付き期待値をとっても意味がないことを示している。上の公式は容易に以下のように一般化できる。
$$E(X|Y_1,\dots,Y_{n-1}) = E[E(X|Y_1,\dots,Y_n)|Y_1,\dots,Y_{n-1}]$$
- $E[g(X_1,\dots,X_n)|X_1,\dots,X_n] = g(X_1,\dots,X_n)$。 すなわち、情報 $X_1,\dots,X_n$ の関数に関する条件付き期待値は、その関数自身である。
$(X,Y)$ が離散型確率変数の場合、$P(X=x_i,Y=y_j)=p_{ij}$、$E|X|<\infty, E|Y|<\infty$ とし、次のように定義する。
ここで $p(i|j)=p_{ij}/p_{\cdot j}$ は条件付き確率であり、それぞれ $Y=y_j$ の下での確率変数 $X$ の条件付き期待値を求めている。 一般に、離散型確率ベクトルの場合でもこれは成立する。
マルチンゲールおよびマルチンゲール差分過程の定義と例
例 6.2 2人で公平な賭けを行うとする。公平な賭けとは、各局で各人が勝つ可能性が等しいことを指す。引き分けはないと仮定し、$X_n=1$ と $X_n=-1$ をそれぞれ第 $n$ 局目でプレイヤー甲が勝つこと、負けることとする。明らかに $X_n \ (n=1,\dots)$ は独立同分布(i.i.d.)で、$P(X_n=\pm1)=1/2 \ (n=1,\dots)$ である。$a_i$ を第 $n$ 局目の賭け金とし、これは過去 $i-1$ 局の結果に基づいて決めることができるとする。すなわち、$a_i=a_i(X_1,\dots,X_{i-1}),\ i\ge2,\ a_1=1$ である。甲の初期資金を $a$ とすると、第 $n$ 局目における甲の損益は $a_n(X_1,\dots,X_{n-1})X_n$ となり、$n$ 局目終了後の甲の総資金 $M_n$ は
となる。過去 $n-1$ 局の勝敗結果を知っているという条件の下で、第 $n$ 局目の甲の平均資金 $E(M_n|X_1,\dots,X_{n-1})$ を観測してみる。
条件付き期待値の性質(命題1.1)および $X_1, X_2, X_3$ の独立性から、
一般に、次が成り立つ。
これより、マルチンゲール(martingale)列の定義を与える。
定義 6.2 確率過程 $\{M_n, n=0,1,\dots\}$ が以下の2つの条件を満たすとき、マルチンゲール列、または単にマルチンゲールと呼ぶ。
- $E|M_n| < \infty$
- $E(M_{n+1}|M_0,M_1,\dots,M_n) = M_n$
また、$\{Z_n=M_n-M_{n-1}, n=1,\dots\}$ をマルチンゲール差分(差分列)と呼ぶ。
例 6.3 $\{X_n, n=0,1,\dots\}$ をi.i.d.、$EX_n=0, E|X_n|<\infty$ とし、$M_n=\sum_{i=0}^n X_i$ とすると、$M_n \ (n=0,1,\dots)$ はマルチンゲールであり、$X_n \ (n=0,1,\dots)$ はマルチンゲール差分である。
例6.2からわかるように、公平な賭博の条件下では、甲の $n$ 局後の資金 $M_n$ はマルチンゲール列を構成する。条件付き期待値の定義によれば、ここでの「条件」は時刻 $n$ までの関連情報であり、これらの情報は過程自体からも、他の過程からも提供され得る。例6.2において時刻 $n$ までの情報は過去 $n$ 局の勝敗状況によって提供されており、必ずしも甲の資金列 $M_0,M_1,\dots,M_n$ である必要はない。したがって、マルチンゲール列の定義を以下のように拡張できる。
定義 6.3 $\{M_n, n=0,1,\dots\}$ と $\{X_n, n=0,1,\dots\}$ を2つの確率過程とする。過程 $\{M_n\}$ が $\{X_n\}$ に関してマルチンゲールであるとは、各 $n=0,1,\dots$ について以下が成り立つことをいう。
- $E|M_n| < \infty$
- $E(M_{n+1}|X_0,X_1,\dots,X_n) = M_n$
この定義は明らかに定義6.2($X_n=M_n \ (n=0,1,\dots)$ とすればよい)を含んでいる。すなわち、$X_0,X_1,\dots,X_n$ によって提供される情報は $\{M_0,M_1,\dots,M_n\}$ よりも詳細である。今後、混乱が生じない限り、情報を提供する確率過程については明記せず、単に $\{M_n\}$ をマルチンゲールと呼ぶ。
条件付き期待値の平滑化の性質、式((式))および数学的帰納法より、
これは、マルチンゲール列にとって、各時点の期待値が全く変化しないことを示している。
例 6.4 $Y_n$ と $X_n$ を2つの確率変数ベクトル列とし、$E|Y_n|<\infty \ (n=0,1,\dots)$ とする。
とすると、$\{M_n\}$ は $\{X_n\}$ に関してマルチンゲールである。
証明. $E|Z_n| \le E|Y_n| + E[E(|Y_n||X_0,\dots,X_{n-1})] = 2E|Y_n|$ より、
$Z_n$ の定義より、$Z_n$ は $X_0,\dots,X_n$ の関数であるため、条件付き期待値の性質より、
したがって、
注 6.1 便宜上、$X_0,\dots,X_n$ によって提供される情報の全体を $\mathcal{F}_n$ と記すことが多い。これらの情報が $X_0,\dots,X_n$ によって提供されることを明確にするため、$\mathcal{F}_n=\sigma(X_0,\dots,X_n)$ と記す。$n$ が大きいほど情報が多くなる。すなわち、$\mathcal{F}_n$ に含まれる情報は $n$ の増加に伴って増加するため、$\mathcal{F}_n$ は単調増加(増大)であるという。このとき、条件付き期待値 $E(M_{n+1}|X_0,\dots,X_n)$ を $E(M_{n+1}|\mathcal{F}_n)$ と記し、マルチンゲールは次のように表現される。
注 6.2 情報集合 $\mathcal{F}_n$ は必ずしも確率ベクトル $X_0,\dots,X_n$ によって提供される必要はなく、一般に一定時間内の事象の集合から構成される。情報集合 $\mathcal{F}$ は次のような基本性質を持つ。情報 $A_1,\dots,A_k,\dots$ がすべて情報集合に含まれている場合、これらの情報の積(交わり)、和(結び)、差、および補集合なども依然として $\mathcal{F}$ の情報である。情報集合がマルチンゲール列に与える影響を十分に表現するため、マルチンゲール列 $\{M_n, n\ge0\}$ を $\{M_n, \mathcal{F}_n, n\ge0\}$ と記す。
例 6.5(例6.4のさらなる一般化) 例6.4の条件下で、$a_n=a_n(X_0,\dots,X_{n-1})$、$W_n=a_n[Y_n-E(Y_n|X_0,\dots,X_{n-1})]$ とすると、$R_n=\sum_{i=1}^n W_i$ は $\{X_n, n\ge0\}$ に関してマルチンゲールである。
証明. $a_n=a_n(X_0,\dots,X_{n-1})$ が $(X_0,\dots,X_{n-1})$ の関数であることに注意すると、
したがって、$\{R_n\}$ は $\{X_n\}$ に関してマルチンゲールである。例6.2(賭け金の設定の例)がまさにこの状況である。
例 6.6 $X_0=0$ とし、$X_n$ をi.i.d.な確率変数ベクトル列で、$EX_n=0, EX_n^2=\sigma^2$ とする。$M_0=0, M_n=\sum_{i=1}^n X_i^2 - n\sigma^2$ とすると、$\{M_n\}$ はマルチンゲールである。
証明. $E|M_n| \le \sum_{i=1}^n EX_i^2 + n\sigma^2 < \infty$ である。$\mathcal{F}_n=\sigma(X_0,\dots,X_n)$ と記す。$X_{n+1}^2-\sigma^2$ は $(X_0,\dots,X_n)$ と独立であることに注意すると、
例 6.7 $X_n \ (n\ge0)$ を既約かつエルゴード的な定常マルコフ過程とし、1歩推移確率行列を $P=(p_{ij})$、$\pi(i)$ を $X_n$ の定常分布とする。すなわち、以下を満たす。
$M_n = \pi(X_n)$ と記すと、$M_n$ は $X_n$ に関してマルチンゲールである。
証明. $\pi(i) \le 1$ であるため、$E|M_n| \le 1$ となる。式((183))と式((184))(離散型の条件付き期待値の定義)より、
したがって、
例 6.8 $\{X_n, n\ge0\}$ を分枝過程とし、$X_n$ を第 $n$ 世代の個体数、$Z_i$ をある世代の第 $i$ 番目の個体が繁殖する子孫の数とする。したがって $X_{n+1} = \sum_{i=1}^{X_n} Z_i$ となる。$EZ_i=\mu$、$M_n=\mu^{-n}X_n$、$M_0=1$ とすると、$\{M_n, n\ge0\}$ はマルチンゲールである。
証明. 分枝過程の定義より、
すなわち $E(X_{n+1}|X_n) = \mu X_n$ である。マルコフ性より、
例 6.9 例6.4において、$Y_n=Y$、$E|Y|<\infty$ とし、$\{X_n, n\ge0\}$ を任意の確率変数ベクトル列とする。$M_n=E(Y|X_0,\dots,X_n)$ とすると、$\{M_n, n\ge0\}$ はDoobマルチンゲールと呼ばれる。 条件付き期待値の平滑化の性質を用いれば、ただちにこの結果が得られる。
例 6.10 $X_t \ (t=0,1,\dots)$ をある先物価格とし、有界な確率変数ベクトル列であるとする。したがって $E|X_t|<\infty$ である。$t$ を現在とすると、$X_{t+T}$ は現在から $T$ 単位時間後の先物価格を表す。$\mathcal{F}_t$ を時刻 $1,\dots,t$ において表現される全ての情報とする。Fama (1970) は、$\mathcal{F}_t$ を特徴付けるために、ウィーク型情報集合、セミストロング型情報集合、およびストロング型情報集合という用語を導入した。$Y_t$ を時刻 $t$ に価格以外で公開された情報、$Z_t$ を時刻 $t$ における価格と公開情報以外のその他の情報とする。
- ウィーク型情報集合 $\mathcal{F}_t^w = \{t \text{ 時刻までの全ての価格情報}\} = \sigma(X_0,X_1,\dots,X_t)$
- セミストロング型情報集合 $\mathcal{F}_t^{se} = \{t \text{ 時刻までの全ての公開情報}\} = \sigma(X_0,Y_0,X_1,Y_1,\dots,X_t,Y_t)$
- ストロング型情報集合 $\mathcal{F}_t^s = \{t \text{ 時刻までの全ての公開および内部情報}\} = \sigma(X_0,Y_0,Z_0,X_1,Y_1,Z_1,\dots,X_t,Y_t,Z_t)$
明らかに、$\mathcal{F}_t^w$ の情報が最も少なく、$\mathcal{F}_t^s$ の情報が最も多い。もし $\{X_t, t=0,1,\dots\}$ がそれぞれ $\mathcal{F}_t^w, \mathcal{F}_t^{se}, \mathcal{F}_t^s$ に関してマルチンゲールを構成するならば、市場はそれぞれウィーク型効率的、セミストロング型効率的、ストロング型効率的であると呼ばれる。
$Y(T,t)$ を時刻 $t$ において提示された $T$ 期後(すなわち時刻 $t+T$)の先物価格とする。$t+1$ 時刻において提示された時刻 $t+T$ の先物価格は $Y(T-1,t+1)$ と記される。こうして、時刻 $t+k \ (k<T)$ における $t+T$ 時刻の先物価格の予測列を得る。
Samuelson (1965) の基本仮定は、$\mathcal{F}_t$ を知っている条件下で計算される先物価格は期末価格の期待値に等しいというものである。これは Muth (1961) の合理的期待に似ている。すなわち、
条件より、$E|Y(T,t)|<\infty$ である。以下に $\{Y(T-k,t+k), k=0,1,\dots,T-1\}$ がマルチンゲールであることを証明する。 $Y(T-1,t+1) = E(X_{t+T}|\mathcal{F}_{t+1})$ および条件付き期待値の平滑化の公式より、
同様に、
したがって、$\{Y(T-k,t+k), k=0,1,\dots,T-1\}$ はマルチンゲールである。
6.3 マルチンゲールおよびマルチンゲール差分の性質
6.3.1 マルチンゲールの性質
前節からわかるように、マルチンゲール過程は非常に広いクラスの過程であり、我々がよく目にするいくつかの過程はマルチンゲールである。$\{\mathcal{F}_n, n\ge0\}$ を単調増加な情報集合とし、$\{M_n, n\ge0\}$ が情報集合 $\{\mathcal{F}_n, n\ge0\}$ に関してマルチンゲールであるとする。定義より、
これは、時刻 $n$ 以前のすべての情報を知っているという条件の下で、次の時刻の過程に対する最良の予測が $M_n$ であることを示している。次に、これはマルコフ性を持つことを示しており、現在およびそれ以前の時刻の過程の値を知っているならば、次の時刻の過程の平均値は現在の値になる。さらに $EM_n=EM_0$ より、マルチンゲール過程の平均は定常であるが、分散は非減少であることがわかる。まず、条件付きイェンセン(Jensen)の不等式より、
したがって、
これは、マルチンゲール過程において時間の経過とともにその変動性(ボラティリティ)も増加することを示している。
6.3.2 マルチンゲール差分の性質
マルチンゲール差分の定義より、$\{M_n, n\ge0\}$ がマルチンゲール列であれば、$\{Z_n=M_n-M_{n-1}, n\ge1\}$ はマルチンゲール差分列である。ゆえに
すなわち、マルチンゲールはマルチンゲール差分の和である。以下では $\{Z_n, n\ge0\}$ をマルチンゲール差分列とする。
性質1 $\mathrm{Cov}(Z_i, Z_j) = 0 \ (i\neq j)$。
$i<j$ としても一般性を失わない。このとき、
性質2 $\{Z_n, n\ge0\}$ が平均ゼロの独立な確率変数ベクトル列であるとき、$\{Z_n, n\ge0\}$ は $\{Z_n\}$ に関してマルチンゲール差分列である。
独立性より直ちに得られる。
無相関とは2つの確率変数間に線形関係がないことを意味し、独立とは一方がどのような値をとっても他方に影響を与えないことを意味することはよく知られている。性質1と性質2は、マルチンゲール差分列における任意の2つの確率変数の相関関係が、互いに直交することと独立であることの間にあることを示している。マルチンゲールはマルチンゲール差分の和であるため、平均ゼロの独立確率変数ベクトル列の部分和列はマルチンゲールの1つの特殊なケースである。特に、$\{Z_n, n\ge0\}$ が独立同分布(i.i.d.)であり、$P(Z_n=\pm 1)=1/2$ であるとき、$\{M_n=\sum_{i=1}^n Z_i\}$ はランダムウォーク(random walk)と呼ばれる。定義より $\{M_n, n\ge0\}$ は平均ゼロのマルチンゲールであり、
となる。
6.4 劣(優)マルチンゲールとその初等的な性質
定義 6.4 $\{M_n, n\ge0\}$ を確率過程、$\{\mathcal{F}_n, n\ge0\}$ を単調増加な情報集合とする。もし
ならば、$\{M_n, n\ge0\}$ は $\mathcal{F}_n, n\ge0$ に関して劣マルチンゲール(submartingale)列であるといい、単に $\{M_n\}$ は劣マルチンゲールであるという。もし
ならば、$\{M_n, n\ge0\}$ は $\mathcal{F}_n, n\ge0$ に関して優マルチンゲール(supermartingale)列であるといい、単に $\{M_n\}$ は優マルチンゲールであるという。
明らかに、等号が成立するときはマルチンゲール列である。式((188))より、$\{M_n, n\ge0\}$ がマルチンゲールであれば、$\{M_n^2, n\ge0\}$ および $\{|M_n|, n\ge0\}$ は劣マルチンゲールである。$\{M_n, n\ge0\}$ が優マルチンゲールであれば、$\{-M_n, n\ge0\}$ は劣マルチンゲールである。したがって、以下では重点的に劣マルチンゲールについて議論する。
劣(優)マルチンゲールの性質を述べるために、証明なしで1つの補題を与える。
補題 6.1(条件付きイェンセンの不等式) $\phi(x)$ を区間上の凸関数(convex function)、情報集合を $\mathcal{F}$ とし、$E|\phi(X)|<\infty$ とすると、
劣マルチンゲールには以下の性質がある:
- $\{X_n, \mathcal{F}_n, n\ge0\}$ をマルチンゲール、$g$ を凸関数、$E|g(X_n)|<\infty$ とすると、$\{g(X_n), \mathcal{F}_n, n\ge0\}$ は劣マルチンゲールである。
- $\{X_n, \mathcal{F}_n, n\ge0\}$ を劣マルチンゲール、$g$ を非減少な凸関数、$E|g(X_n)|<\infty$ とすると、$\{g(X_n), \mathcal{F}_n, n\ge0\}$ も劣マルチンゲールである。
(i) $X_n$ がマルチンゲールであるため、$E(X_n|\mathcal{F}_{n-1})=X_{n-1}$ であり、したがって $g(E(X_n|\mathcal{F}_{n-1}))=g(X_{n-1})$ となる。条件付きイェンセンの不等式より直ちに(i)が得られる。(ii)の結果については、$g$ の非減少性と条件付きイェンセンの不等式から得られる。
注 6.3 $\{X_n\}$ がマルチンゲールであるとき、$\{\max(X_n,0)\}$、$\{|X_n|^p\} \ (p\ge 1)$ は劣マルチンゲールである。
例 6.11 先物価格付けの例において、割引を考慮する場合、$T$ 期後の先物価格を $Y(T,t) = (1+r)^{-T}E(X_{t+T}|\mathcal{F}_t)$ とすると、このとき $Y(T-k, t+k) \ (k=0,1,\dots,T-1)$ はもはやマルチンゲールを構成せず、劣マルチンゲール列となる。
証明.
すなわち、時刻 $t$ 以前の情報に基づき時刻 $t+1$ に予測する時刻 $t+T$ の先物価格は、時刻 $t$ に予測する時刻 $t+T$ の先物価格を下回らない。これは1965年にSamuelsonが「現物プレミアム(normal backwardation / contango)」に対して与えた合理的な解釈である。つまり、先物市場のマルチンゲール性は、過去の価格情報を利用して超過収益モデルを構築しようとするいかなる手法も失敗する運命にあることを示している。
我々が関心を持つもう一つの問題は、マルチンゲールや劣(優)マルチンゲールがいつ確率変数に収束するのかということである。以下の定理がある。
定理 6.1(マルチンゲール収束定理) $\{X_n, n\ge0\}$ を劣マルチンゲールとし、$\sup_n E|X_n| \le K < \infty$ を満たすとする。このとき、ある確率変数 $X$ が存在して、$X_n$ は確率1で $X$ に収束し、$E|X| \le K < \infty$ を満たす。
マルチンゲール収束定理は、劣マルチンゲールの平均に上界があれば、その劣マルチンゲール列は必ず確率1で収束することを示している。マルチンゲールは劣マルチンゲールの特殊なケースであるため、定理の条件を満たせば必ず確率1で収束する。
この定理の証明は賢明な読者に任せよう。定理の証明はマルチンゲール(劣マルチンゲール)のアップクロッシング(上向き交差)不等式に依存している。
$[a,b]$ を任意の閉区間($a<b$)とし、$X_1,\dots,X_n$ を確率変数列とする。$N$ を $X_1,\dots,X_n$ が $a$ より小さい値から開始して $b$ を上向きに交差する回数とする。図6.1に $n=20$ の場合の模式図を示す。
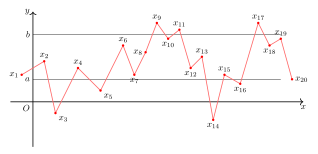
図において最初に $a$ より小さくなるのは $x_3$、そこから初めて $b$ を超えるのは $x_9$ であり、$x_3$ から $x_9$ への変化を1回目のアップクロッシングと呼ぶ。その後、図中の $x_{14}$ で再び $a$ より小さくなり、$x_{14}$ の後で $x_{17}$ が初めて $b$ の上方にくるため、$x_{14}$ から $x_{17}$ への変化を2回目のアップクロッシングと呼ぶ。……図中には合計2回のアップクロッシングがあり、すなわち $N=2$ である。次が証明できる。
補題 6.2(アップクロッシング不等式) $X_1,\dots,X_n$ を劣マルチンゲール列とする。$[a,b]$ をアップクロッシングする回数 $N$ の期待値 $EN$ は、以下の不等式を満たす。
証明は難しくない。この不等式はマルチンゲール収束定理の証明に用いられるだけでなく、それ自体にも意義がある。例えば、株価の上昇・下落の法則の研究などに応用できる。
6.5 連続時間におけるマルチンゲール過程と劣マルチンゲール過程
$\{X(t), t\in T\}$ を連続時間確率過程とし、$\mathcal{F}_s$ を時刻 $s$ までに表現される全ての情報とする。例えば $\mathcal{F}_s = \sigma(X(r), r\le s)$ であり、厳密には時刻 $s$ までの $\sigma$-代数(または $\sigma$-加法族)と呼ばれる。$\mathcal{F}_{s^-}$ を時刻 $s$ より前の全ての情報とする。例えば $\mathcal{F}_{s^-} = \sigma(X(r), r<s)$ である。明らかに $\mathcal{F}_{t^-} \subseteq \mathcal{F}_t$ であり、$\mathcal{F}_t$ は単調増加な $\sigma$-代数流(すなわち単調増加な情報集合の族、フィルトレーション)であると呼ばれる。$X(t)$ によって提供される情報が全て $\mathcal{F}_t$ に含まれている場合、これを $X(t) \in \mathcal{F}_t$ と記し、$\{X(t), \mathcal{F}_t, a\le t\le b\}$ は $\{\mathcal{F}_t, a\le t\le b\}$ に関して適合過程(adapted process)であるといい、単に $\{X(t), a\le t\le b\}$ は適合過程であるという。このとき任意の $s\le t$ に対して、$E(X(s)|\mathcal{F}_t) = X(s)$ となる。
定義 6.5 $\{X(t), \mathcal{F}_t, a\le t\le b\}$ を適合過程とする。もし任意の $a\le s<t$ に対して、
が成り立つとき、$\{X(t), a\le t\le b\}$ は $\{\mathcal{F}_t, a\le t\le b\}$ に関してマルチンゲール(劣マルチンゲール、優マルチンゲール)であるといい、情報集合 $\{\mathcal{F}_t, a\le t\le b\}$ を強調しない場合は単にマルチンゲール(劣マルチンゲール、優マルチンゲール)と呼ぶ。
我々が遭遇する情報集合 $\{\mathcal{F}_t\}$ の多くは、過程 $\{X(t), a\le t\le b\}$ 自身によって提供されるものである。すなわち $\mathcal{F}_t = \sigma(X(s), a\le s\le t)$ である。
例 6.12 $W(t)$ を $[0,\infty)$ 上のブラウン運動とし、$\{\mathcal{F}_t = \sigma(W(s), 0\le s\le t), t\in[0,\infty)\}$ とすると、ブラウン運動はマルチンゲール過程である。
証明. 任意の $s<t$ に対して、ブラウン運動が独立増分過程であることに注意する。したがって、$W(t)-W(s)$ は情報集合 $\mathcal{F}_s$ の各事象と独立である。ゆえに、
マルチンゲールの定義より明らかである。
例 6.13 $\{N(t), t\ge0\}$ を強度 $\lambda$ のポアソン過程とし、$\{\mathcal{F}_s = \sigma(N(r), r\le s), s\in[0,\infty)\}$ とすると、$\{N(t)-\lambda t, t\in[0,\infty)\}$ はマルチンゲール過程である。
証明. 任意の $s<t$ に対して、ポアソン過程が独立増分過程であることに注意する。したがって、$N(t)-N(s)$ は情報集合 $\mathcal{F}_s$ の各事象と独立である。ゆえに、
例 6.14 $\{W(t), t\ge0\}$ をブラウン運動とし、$E[\exp\{iW(t)\}] = E[\cos W(t) + i\sin W(t)]$ をブラウン運動の特性関数とする。このとき、
はマルチンゲール過程である。
証明. $\mathcal{F}_t = \sigma(W(s), s\le t)$ とする。任意の $s\le t$ に対して、$E(M(t)|\mathcal{F}_s)=M(s)$ となることを確かめる。$W(t)$ は独立増分過程であるため、$\exp\{i(W(t)-W(s))\}$ は $\exp\{iW(s)\}$ と独立であり、$\mathcal{F}_s = \sigma(W(r), r\le s)$ とも独立である。したがって、
すなわち $\{M(t), t\ge0\}$ はマルチンゲールである。
6.6 停止時間
定義 6.6 $\mathcal{F}_s \ (s\in S)$ を単調増加な情報集合の族(フィルトレーション)、$T$ を非負の確率変数とする。もし任意の $t$ に対して、事象 $\{T\le t\}$ が $\mathcal{F}_t$ に属する情報である(すなわち $\{T\le t\}\in\mathcal{F}_t$ と記される)ならば、$T$ を $\{\mathcal{F}_t, t\in S\}$ の停止時間(stopping time)と呼ぶ。
$T$ が非負の整数値 $0,1,\dots$ をとる確率変数であり、情報集合の族も離散的である場合、任意の非負整数 $n$ に対して $\{T\le n\} \in \mathcal{F}_n$ であれば、$T$ は停止時間である。
停止時間の直感的な意味は、一連のランダムな試行において、我々が関心を持つ事象が発生する時刻がランダムであるということである。例えば、2人が公平な賭けを行い、5回勝負で3勝した方が勝ちであると約束した場合、$T$ をゲームが終了する時間とすると、$T$ は停止時間である。停止時間の定義は、もしゲームがある確定した時刻 $n$ で終了するならば、その事象は必ず情報集合 $\mathcal{F}_n$ の中に含まれることを意味している。
明らかに、集合 $\{T\le n\}\in\mathcal{F}_n$ は $\{T=n\}\in\mathcal{F}_n$ と同値である。これは情報集合の基本性質から得られる。$\{T\le n\} = \{T\le n-1\} \cup \{T=n\}$ であり、$\{T\le n-1\}\in\mathcal{F}_{n-1}\subset\mathcal{F}_n$ であるため、$\{T=n\} = \{T\le n\} \setminus \{T\le n-1\} \in \mathcal{F}_n$ となる。逆に、$\{T\le n\} = \bigcup_{k=0}^n \{T=k\}$ であり、$\{T=k\}\in\mathcal{F}_k\subset\mathcal{F}_n$ であるから、$\{T\le n\}\in\mathcal{F}_n$ となる。
例 6.15 $B$ を直線上の区間とし、$\{X_n, \mathcal{F}_n, n\ge1\}$ を適合過程とする。$T_B = \inf\{n: X_n \in B\}$ と定義する。もし任意の $n$ に対して $X_n$ が $B$ に含まれない場合は、$T_B = \infty$ と定義する。$T_B$ は初到達時間(first passage time)と呼ばれる。$\tau_B = T_B I(T_B < \infty)$ と定義すると、$\tau_B$ は停止時間である。
証明. $\tau_B$ が停止時間であることを検証する。
$\{T_B=n\} \in \mathcal{F}_n$ であり、また $\{T_B < \infty\} = \{T_B \le n\} \cup \{T_B > n\}$ である。 $\{T_B \le n\} \in \mathcal{F}_n$ かつ $\{T_B > n\} = \{T_B \le n\}^c \in \mathcal{F}_n$ であるため、$\{\tau_B=n\} \in \mathcal{F}_n$ となる。すなわち $\tau_B$ は停止時間である。
例 6.16 $X_n \ (n\ge1)$ を確率変数列とし、$P(X_n=\pm1)=\frac{1}{2}$ とする。ランダムウォークを $S_n=\sum_{k=1}^n X_k$ と記す。ランダムウォーク $S_n$ は、原点を出発した質点の時刻 $n$ における変位を表し、質点は毎回左右に等確率で1歩ずつランダムに移動する。$K=\{k: S_k=1, k\ge1\}$ とする。すなわち $K$ は変位が1となる全ての時間の集合であり、$T$ を初めて変位1に到達する時間とする。
$\tau = T I(T<\infty)$ は停止時間である。
時刻 $k$ までの情報集合を $\mathcal{F}_k$ と記すと、$S_k \in \mathcal{F}_k$ である。したがって $T$ は初到達時間であり、上の例より停止時間であることがわかる。次に $\tau$ の分布を求める。
したがって $\{S_n \ge 1\} \subset \{\tau \le n\}$ であり、
$\tau$ の定義より、$\tau=k$ のとき $S_k=1$ である。したがって、
ここで、第2行目の最初の等式は事象 $\{\tau=k\}$ が $S_n-S_k$ と独立であることによる。第2行目の2番目の等式および最終行の最後の等式は、すべての $i$ について $X_i$ と $-X_i$ が同分布であることによる。最終行の2番目の等式は上述の事象の包含関係に基づく。ゆえに、
$n=2m$ が偶数のとき、$S_{2m}$ が $-1$ になることは不可能であるため、
$n=2m-1$ が奇数のとき、$S_{2m-1}$ が $0$ になることは不可能であるため、
これより、$P(T = \infty) \le \lim_{n\to\infty} P(T > n) = 0$ となり、すなわち $T = \tau \ a.s.$ がわかる。 $E\tau = \sum_{n=0}^\infty P(\tau > n) = \infty$ であるため、$E\tau = +\infty$ となる。これは、有限時間内に位置1にほぼ確実に到達できるが、平均到達時間は $+\infty$ であることを示している。
定理 6.2(ウォルド (Wald) の等式) $\{X_n, n\ge1\}$ をi.i.d.な確率変数列とし、$E|X_1|<\infty$ とする。$\mathcal{F}_n = \sigma(X_1,\dots,X_n)$ と記し、$T$ を $ET<\infty$ を満たす $\{\mathcal{F}_n, n\ge1\}$ の停止時間とする。このとき、
任意の $n\ge1$ について、$I_{\{T\ge n\}} = 1 - I_{\{T<n\}}$ は $X_n$ と独立であることに注意する。したがって、
したがって、上の式において $|X_n|$ を $X_n$ で置き換えると、期待値と総和の順序を交換でき、定理が得られる。
練習問題 6
1. $\{X_n\}$ をi.i.d.とし、$P(X_n=2)=p$、$P(X_n=1/2)=1-p$、$S_{n+1}=X_{n+1}\cdot S_n$ とする。 (i) $p=1/3$ のとき、$\{S_n, n\ge1\}$ がマルチンゲールであることを証明せよ。 (ii) $p>1/3$ のとき、$\{S_n, n\ge1\}$ が劣マルチンゲールであり、$\{S_n/(1+\gamma)^n, n\ge1\}$ がマルチンゲールであることを証明せよ。ただし $\gamma=(3p-1)/2$ とする。 (iii) $p<1/3$ のとき、$\{S_n, n\ge1\}$ が優マルチンゲールであることを証明せよ。
2. $\{M_n, n\ge1\}$ は単調増加なフィルトレーション $\{\mathcal{F}_n, n\ge1\}$ に関してマルチンゲールであり、$\{\Delta_n, n\ge1\}$ は $\{\mathcal{F}_n, n\ge1\}$ に関する適合過程であるとする。$I_0=0$ と記し、
とする。$I_0, I_1, \dots, I_N$ がマルチンゲールであることを証明せよ。
3. 分布を $F_n=F$、$G_n=G \ (n\ge1)$ とする。分布 $F$ と $G$ は3つの標本点 $1,2,4$ 上にのみ質量を持ち、$F$ の質量分布は $1/3, 1/3, 1/3$、$G$ の質量分布は $1/5, 1/5, 3/5$ である。$X_n$ の標本点 $1,2,4$ 上での値はそれぞれ $2n, n, -n$ であるとする。$\{X_n\}$ は $\mathcal{F}_n=\{F_n\}$ に関してはマルチンゲールではないが、$\mathcal{G}_n=\{G_n\}$ に関してはマルチンゲールであることを証明せよ。
付録 A
定理 4.5 の証明
十分性:$\hat{X}^*$ を $\mathcal{H}$ 内の1つの予測子とし、$\mathcal{H}$ 内の各予測子 $U$ に対して $E[(X-\hat{X}^*)U]=0$ が成り立つとする。 $\hat{X}^*$ が最小平均二乗誤差を持つことを証明する。$\hat{X}$ を任意の許容される予測子(すなわち $\hat{X}\in\mathcal{H}$)とすると、
$U = \hat{X}^*-\hat{X}$ とおく。これは $\hat{X}^*$ と $\hat{X}$ の線形結合であり、定理の条件より $U\in\mathcal{H}$ であることがわかる。したがって式((89))より
ゆえに、
すなわち、$\hat{X}^*$ は最小平均二乗誤差を持つ。
必要性:$\hat{X}^*\in\mathcal{H}$ を最適予測子とする。各 $U\in\mathcal{H}$ に対して式((89))が成立することを背理法で証明する。成立しないと仮定し、ある $U\in\mathcal{H}$ に対して $E[(X-\hat{X}^*)U]=\alpha\neq0$ となる。
とすると、$\hat{X} - \hat{X}^* = \frac{\alpha}{EU^2}U$ であり、
すなわち、$\hat{X}$ の平均二乗誤差は $\hat{X}^*$ の平均二乗誤差よりも小さくなる。これは $\hat{X}^*$ が最適予測子であるという条件に矛盾する。以上により必要性が証明された。
付録 B
$\mathcal{H}$ を $1, X_1, \dots, X_n$ によって生成される線形空間とする。すなわち、$\mathcal{H}$ の要素は $1, X_1, \dots, X_n$ の線形結合である。$X$ を任意の2次モーメントが存在する確率変数とする。もし $X$ の予測クラスを $\mathcal{H}$ 内に限定する場合、すなわち $1, X_1, \dots, X_n$ の線形結合のみに限定する場合、$Y=(X_1,\dots,X_n)'$ と記し、$\hat{E}(X|Y)$ を $X$ の $\mathcal{H}$ 上への射影とする。 定理 4.5 より、$\hat{E}(X|Y)$ は $X$ の $1, X_1, \dots, X_n$ に基づく線形最適予測子であり、以下の明示的な表現を持つことがわかる。
ここで $\mathrm{Cov}(X,Y)$ および $\mathrm{Var}(Y)$ は以下のように定義される。
最小誤差分散予測子の定義より、我々は $E(X-\hat{X})^2$ を最小化する $\mathcal{H}$ 内の要素 $\hat{X}$ を求めることである。$\hat{X} = a_0 + AY$(ここで $A=(a_1,\dots,a_n)$)とおくと、我々は $E(X-a_0-AY)^2$ を最小化する $a_0$ と $A$ を選択することになる。
とおく。ここで $EY = (EX_1,\dots,EX_n)'$ である。すると $E(X-\hat{X})^2$ は次のように書き換えられる。
式(B.3)の右辺の最初の2項はともに非負であり、第3項は $b$ や $A$ に無関係である。したがって、式(B.3)を最小化するための唯一の解は、最初の2項がともにゼロになるように $b$ と $A$ を選ぶことである。すなわち、
式(B.4)と(B.5)を $b$ の定義式に代入すると、
式(B.5)と(B.6)より、線形最適予測子は直ちに得られる。
付表 よく用いられる確率変数の分布と積率母関数
離散型確率分布
| 分布 | $P(X=x)$ | 積率母関数 $g(t)$ | $E[X]$ | $\mathrm{Var}(X)$ |
| 二項分布 $B(n,p)$ $0\le p\le1$ $x=0,1,\dots,n$ | $\displaystyle \binom{n}{x}p^x(1-p)^{n-x}$ | $(pe^t+(1-p))^n$ | $np$ | $np(1-p)$ |
| ポアソン分布 $\lambda>0$ $x=0,1,2,\dots$ | $\displaystyle e^{-\lambda}\frac{\lambda^x}{x!}$ | $\exp\{\lambda(e^t-1)\}$ | $\lambda$ | $\lambda$ |
| 幾何分布 $0\le p\le1$ $x=1,2,\dots$ | $p(1-p)^{x-1}$ | $\displaystyle \frac{pe^t}{1-(1-p)e^t}$ | $\displaystyle \frac{1}{p}$ | $\displaystyle \frac{1-p}{p^2}$ |
| 負の二項分布 パラメータ $r, p$ $x=r,r+1,\dots$ | $\displaystyle \binom{x-1}{r-1}p^r(1-p)^{x-r}$ | $\displaystyle \left(\frac{pe^t}{1-(1-p)e^t}\right)^r$ | $\displaystyle \frac{r}{p}$ | $\displaystyle \frac{r(1-p)}{p^2}$ |
連続型確率分布
| 分布 | $f(x)$ | 積率母関数 $g(t)$ | $E[X]$ | $\mathrm{Var}(X)$ |
| 一様分布 $U(a,b)$ | $\displaystyle \frac{1}{b-a}, \quad a<x<b$ | $\displaystyle \frac{e^{tb}-e^{ta}}{t(b-a)}$ | $\displaystyle \frac{a+b}{2}$ | $\displaystyle \frac{(b-a)^2}{12}$ |
| 指数分布 $\lambda>0$ $x\ge0$ | $\lambda e^{-\lambda x}$ | $\displaystyle \frac{\lambda}{\lambda-t}$ | $\displaystyle \frac{1}{\lambda}$ | $\displaystyle \frac{1}{\lambda^2}$ |
| ガンマ分布 $\Gamma(n,\lambda)$ $\lambda>0$ $x\ge0$ | $\displaystyle \frac{\lambda e^{-\lambda x}(\lambda x)^{n-1}}{(n-1)!}$ | $\displaystyle \left(\frac{\lambda}{\lambda-t}\right)^n$ | $\displaystyle \frac{n}{\lambda}$ | $\displaystyle \frac{n}{\lambda^2}$ |
| 正規分布 $N(\mu,\sigma^2)$ | $\displaystyle \frac{1}{\sqrt{2\pi}\sigma}\exp\left\{-\frac{(x-\mu)^2}{2\sigma^2}\right\}$ | $\displaystyle \exp\left\{\mu t+\frac{\sigma^2 t^2}{2}\right\}$ | $\mu$ | $\sigma^2$ |
| ベータ分布 $B(a,b)$ $c=\frac{\Gamma(a+b)}{\Gamma(a)\Gamma(b)}$ $a>0, b>0$ $0<x<1$ | $cx^{a-1}(1-x)^{b-1}$ | $\displaystyle \frac{a}{a+b}$ | $\displaystyle \frac{ab}{(a+b)^2(a+b+1)}$ |
}