イントロ
確率過程は、一連の確率事象間の動的関係を定量的に記述したものであり、自然科学、工学、社会科学の各分野において確率現象を研究するための強力なツールである。その応用は多岐にわたり、気象予報、天文観測、通信工学、原子物理学、宇宙遠隔制御、生物医学、管理科学、オペレーションズ・リサーチ、計算機科学、経済分析、金融工学、人口理論、信頼性・品質管理など、数多くの分野で確率過程の理論を用いたさまざまな数学的モデルの構築が不可欠となっている。
一般に、確率変数の族を確率過程と定義し、英語では stochastic process と呼ぶ。「stochastic」という言葉はギリシャ語の「$\sigma\tau\circ\chi\alpha\sigma\tau\iota\kappa\circ\xi$」に由来し、「推測する」という意味を持つ。しかし、この科学は当てずっぽうな推測ではない。確率過程を研究する際、人々は表面的な偶然性を透して必然的な内的法則を見出し、これらの法則を確率の形で記述する。偶然の中から必然を悟ることこそが、この学問の魅力である。
確率過程の初期の歴史は物理学の分野に属しており、統計力学におけるGibbs、Boltzman、Poincar\'eらの研究や、その後のEinstein、Wiener、L\'evyらの先駆的な研究に遡ることができる。Erlangらは電話トラフィックにおいてポアソン過程を研究し、分野全体の理論的基礎はKolmogorovとDoobによって確立された。「Stochastic」という用語もこの時期に普及し、出生死滅過程はFellerによって初めて導入された。CramerとL\'evyは定常過程を研究し、Khinchin、Palmは待ち行列理論における過程の理論を発展させた。
また、Doobはマルコフ過程とマルチンゲールを研究した。これらは初期の研究における重要なマイルストーンである。現在、この学問は理論と応用の両面で空前の深さと広がりをもって急速に発展している。以下に確率過程の正式な定義を与える。
定義 1 確率過程とは、あるパラメータ集合 $T$ に属するパラメータ $t$ を持つ確率変数の族 $\{X(t), t\in T\}$ のことである。
一般に、$t$ は時間を表す。$T=\{0,1,2,\dots\}$ のとき、確率過程を確率系列とも呼ぶ。$X(t)$ については次のように見ることができる。確率変数は空間上に定義されているため、$t$ と $\omega \in \Omega$ に応じて変化する。したがって、$X(t,\omega)$ と記すことができる。1回の確率試行を固定する、すなわち $\omega_{0}\in\Omega$ を定めたとき、$X(t,\omega_{0})$ は1つの標本路(サンプルパス)となる。それは $t$ の関数であり、連続であることもあれば、不連続点や跳躍を持つこともある。これが通常我々が観測する過程である。一方、時間 $t=t_{0}$ を固定したとき、$X(t_{0},\omega)$ は1つの確率変数であり、その値は確率試行の結果に応じて変化し、一定の規則性を持つ。これを確率分布と呼ぶ。確率過程が時刻 $t$ においてとる値を過程が置かれている状態と呼び、状態の全体を状態空間と呼ぶ。
$T$ および状態空間の違いにより、過程を分類することができる。状態空間によれば、連続状態と離散状態に分けられる。パラメータ集合 $T$ によれば、$T$ が有限集合または可算集合であるとき離散パラメータ過程と呼び、そうでない場合は連続パラメータ過程と呼ぶ。$T$ が高次元ベクトルの場合、$X(t)$ は確率場と呼ばれる。
例1.1 英国の植物学者Brownは、液面に浮かぶ微小な粒子が絶えず不規則な運動をしていることに気づいた。この運動はブラウン運動と呼ばれ、分子の大量のランダムな衝突の結果である。平面座標上の粒子の位置を $(X(t), Y(t))$ と記せば、これは平面上のブラウン運動であり、統計物理学において深く研究されている。
例1.2 ある酔歩者が道を歩くとき、確率 $p$ で一歩前進し、確率 $1-p$ で一歩後退する。通りにおける彼の位置を $X(t)$ と記せば、$X(t)$ は直線上のランダムウォークである。
例1.3 神経細胞は、細胞膜の電位がある臨界値 $C$ に達すると興奮する。刺激と抑制の2種類のパルスが一定の速度(例えばポアソン過程)で細胞に到達し、前者は電位を上昇させ、後者は電位を低下させる。昇降の幅は同じ分布 $H(x)$ に従う。神経細胞は興奮した後、電位が0に回復し、過程が再び繰り返される。2回の興奮の間隔時間を $T_{i}$ と記し、時刻 $t$ における細胞膜の電位を $X(t)$ と記すと、過程の1回の実現は次の図のようになる。
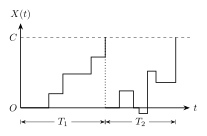
例1.4 電話交換台への呼の到着回数はポアソン過程であり、各呼は互いに独立で、間隔時間は指数分布に従う。交換台は同時に $K$ 個の呼しか接続できない。人々はよく、ある時刻における待ち行列の長さや呼の平均待ち時間を知りたいと思う。これは一種の待ち行列モデルである。
例1.5 疫学の研究において次のようなモデルがある。時刻0において、感染しやすい人口の規模が $X(0)$ であり、$Y(0)$ はすでに感染した人数である。感染しやすい人々が感染する確率を $p$ と仮定する。すると、1つの感染周期(単位時間とする)を経た後、$X(0)$ の中で $X(1)$ 人は病気にかからず、$Y(1)$ 人が感染する。感染過程は、これ以上この流行病に感染する人がいなくなるまで蔓延し続ける。したがって、$X(t)=X(t+1)+Y(t+1)$ となり、かつ $j\le i$ のとき次式が成り立つ。
$\{X(t), t=0,1,2,\dots\}$ は、上式を状態推移確率とするマルコフ過程である。
例1.6 信号流を $X(t)$ とし、それが次の方程式を満たすとする。
ここで $a$ は実パラメータ、$\epsilon(t)$ は誤差を表す。真の信号 $X(t)$ を観測することはできず、観測できるのは
である。$Z(t)$ はノイズである。観測値 $Y(t)$ から $X(t)$ を検出することは通信工学における重要な課題であり、これは過程の予測とフィルタリングの問題である。
例1.7 貯水池の容量スケジューリング。$Y(t)$ を $(t, t+1)$ 年間の貯水池への流入量とする。これは確率的である。$M$ を毎年末の固定された清掃放流量、$K$ をダムの設計容量とすると、
となる。過程 $X(t)$ はマルコフ過程であり、貯水池の容量を商店の倉庫の在庫モデルに置き換えても類似している。
例1.8 時刻 $t$ における商品の価格を $X(t)$ と記す。もし $X(t)$ が線形モデル
に適合する場合、ここで $\alpha_{k}, \beta_{j}$ は実パラメータ、$Z(t)$ は独立同分布の観測不可能な確率変数である。すると $X(t)$ は ARMA モデル(自己回帰移動平均モデル)に従う。これは経済予測において非常に有用な時系列モデルである。
有限次元分布と特性量
分布関数 $F_{X}(x)=P\{X\le x\}$ を知れば、確率変数 $X$ を理解できる。同様に、確率過程 $\{X(t), t\in T\}$ に対して $F_{t}(x)=P\{X(t)\le x\}$ を過程の1次元分布と定義する。$X(t)$ の期待値 $E[X(t)]$ を過程の平均関数と呼び、$\mu_{X}(t)$ と記す。また、$Var[X(t)]$ は過程の分散関数として定義される。それだけでなく、我々は確率変数 $X(t_{1})$ と $X(t_{2})$ の同時分布 $P\{X(t_{1})\le x_{1}, X(t_{2})\le x_{2}\}$ を知る必要がある。これはすなわち過程の $t_{1}, t_{2}$ という2つの異なる時刻における値の同時2次元分布であり、$F_{t_{1},t_{2}}(x_{1},x_{2})$ と記す。特性量 $E[X(t_{1})X(t_{2})]$ および $Cov(X(t_{1}),X(t_{2}))=E\{(X(t_{1})-\mu_{X}(t_{1}))(X(t_{2})-\mu_{X}(t_{2}))\}$ は過程の自己相関関数および共分散関数と呼ばれ、それぞれ $r_{X}(t_{1},t_{2})$ および $R_{X}(t_{1},t_{2})$ と記される。明らかに、自己相関関数と共分散関数は対称性を持つ。すなわち、任意の $s, t$ に対して $r_{X}(t,s)=r_{X}(s,t)$ および $R_{X}(t,s)=R_{X}(s,t)$ となる。$t_{1}=t_{2}=t$ のとき、$R_{X}(t,t)=Var(X(t))$ である。
自己相関関数と共分散関数が非負定値であることは容易に証明できる。共分散関数を例にとれば、すなわち任意の $t_{1},t_{2},\dots,t_{n}\in T$ および任意の実数 $b_{1},b_{2},\dots,b_{n}$ に対して、常に
が成り立つ。共分散の演算は線形性を持つため、
から、式((1))が成立することがわかる。ゆえに非負定値である。
さらに、確率過程の有限次元分布族を定義する。それはすべての $F_{t_{1},t_{2},\dots,t_{n}}(x_{1},\dots,x_{n}), t_{1},\dots,t_{n}\in T$ の全体であり、ここで
である。確率過程の有限次元分布族を知れば、過程 $\{X(t), t\in T\}$ 中の任意の $n$ 個の確率変数の同時分布がわかり、これらの変数間の相互依存関係を完全に理解できる。有限次元分布も対称性を持つ。それは変数 $X(t_{1}),\dots,X(t_{n})$ の順序には無関係であり、$\{1,\dots,n\}$ の任意の置換 $(i_{1},\dots,i_{n})$ に対して
が成り立つ。有限次元分布はまた両立性(適合性)を持つ。これは、ある変数が $\infty$ に向かうとき、高次元分布の周辺分布が対応する低次元分布と一致することを意味する。すなわち、$m<n$ に対して
となる。興味深いことに、与えられた分布関数の族が上述の対称性と両立性を持てば、その有限次元分布族がちょうど与えられた分布関数族となるような確率過程 $\{X(t), t\in T\}$ が存在することが保証される。これが1931年にKolmogorovによって証明された両立性の基本定理である。
例1.9 $X_{n}$ を $n$ 回目に独立に6面サイコロを投げた結果とする。このとき $\{X_{n}, n\ge1\}$ は確率過程であり、パラメータ集合 $T$ は $\{1,2,\dots\}$ である。また状態空間は $\{1,2,3,4,5,6\}$ である。系列 $3,1,4,6,3,2,5,5,1,\dots$ は $\{X_{n}, n\ge1\}$ の1回の可能な実現(サンプルパス)である。平均関数は $E[X_{n}]=E[X_{1}]\equiv3.5$、分散関数は $\frac{35}{12}$ であるほか、共分散関数は恒等的に0である。任意の有限次元分布は $F_{n_{1},\dots,n_{k}}(x_{1},\dots,x_{k})=F(x_{1})\dots F(x_{k})$ であり、ここで $F(x)$ は $X_{1}$ の分布関数である。
もちろんこのような独立な場合は簡単すぎる。大多数の確率過程において、$X(t)$ の間には依存関係がある。それらの間の依存関係を研究することが我々の主要な課題であり、依存関係の違いに基づいて、確率過程の異なるタイプを研究することができる。
定常過程と独立増分過程
もし2つの確率変数 $X_{1}, X_{2}$ の分布関数 $F_{X_{1}}(x)$ と $F_{X_{2}}(x)$ が任意の $x$ に対して等しいとき、それらは同分布であるといい、$X_{1}\stackrel{d}{=}X_{2}$ と記す。同様に、ある確率ベクトル $X=(X_{1},\dots,X_{n})$ が別の確率ベクトル $Y=(Y_{1},\dots,Y_{n})$ と同じ同時分布を持つとき、それらも同分布であるといい、$X\stackrel{d}{=}Y$ と記す。
ある種の確率的平衡状態にある重要な確率過程のクラスがある。その主な性質は変数 $X(t)$ 間の時間間隔にのみ依存し、我々が考察する始点には依存しない。このような過程を定常過程(平稳过程)と呼び、具体的には次のような定義がある。
定義 1 もし確率過程 $X(t)$ が任意の $t_{1},\dots,t_{n}\in T$ と任意の $h$ に対して
を満たすとき、厳密に定常(狭義定常)であるという。
条件((3))は非常に強く検証も容易ではないため、次善の策としていわゆる広義定常または2次定常過程がある。以下の定義を導入する。
定義 1.3 もし確率過程のすべての2次モーメントが存在し、$E[X(t)]=m$ および共分散関数 $R_{X}(t,s)$ が時間差 $t-s$ にのみ依存するとき、広義定常または2次モーメント定常であるという。
広義定常過程に対しては、$-\infty<s,t<\infty$ において $R_{X}(s,t)=R_{X}(0,t-s)$ であるため、$R_{X}(t-s)$ と記すことができる。明らかにすべての $t$ に対して $R_{X}(-t)=R_{X}(t)$、すなわち偶関数であるから、$R_{X}(t)$ のグラフは座標軸に対して対称であり、0点での値 $R_{X}(0)$ はまさに過程の分散関数、すなわち $R_{X}(0)=Var(X(t))$ である。
$X(t)$ 間が互いに独立ではないことがよくあるが、過程の増分間が互いに独立であると仮定することができる。これが以下の定義である。
定義 1.4 もし任意の $t_{1}<t_{2}<\dots<t_{n}$ ($t_{1},\dots,t_{n}\in T$) に対して、確率変数 $X(t_{2})-X(t_{1}), X(t_{3})-X(t_{2}), \dots, X(t_{n})-X(t_{n-1})$ が互いに独立であるとき、$X(t)$ は独立増分過程と呼ばれる。さらに、任意の $t_{1}, t_{2}$ に対して $X(t_{1}+h)-X(t_{1}) \stackrel{d}{=} X(t_{2}+h)-X(t_{2})$ が成り立つとき、過程は定常独立増分過程と呼ばれる。
定常独立増分過程の平均関数は必ず $t$ の線形関数になることが証明できる。我々が後で紹介するポアソン過程とブラウン運動はどちらもこの種の過程であり、これら2つの過程は過程理論における最も重要な2つの礎石である。
例1.10 $Z_{i}, i=0,1,2,\dots$ を互いに独立で同分布な確率変数列とする。$X_{n}=\sum_{i=0}^{n}Z_{i}$ と定義すると、過程 $\{X_{n}, n\ge0\}$ は独立増分過程である。一般に $X_{n}$ は独立和と呼ばれる。
重要な依存タイプには、他にマルコフ連鎖およびマルコフ過程、更新過程、マルチンゲールなどがある。更新過程はオペレーションズ・リサーチや待ち行列理論などの管理科学において重要なツールである。マルチンゲールは近代確率論および確率過程理論において重要な概念である。紙幅と授業時間の制限により、ここでは最も基本的な概念を紹介するにとどめ、一つ一つ詳細な議論を展開することはできない。読者は、過程の分類が絶対的なものではないことに注意すべきである。ある具体的な過程は、上述の複数のタイプに同時に属することができる。例えば、第2章で議論するポアソン過程は独立増分と定常増分の両方を持つ。それは連続時間のマルコフ連鎖でありながら、特殊な更新過程でもある。もし過程のパラメータが $\lambda$ であれば、ポアソン過程 $X(t)$ から平均関数を引いたもの、すなわち $X(t)-\lambda t$ はやはりマルチンゲールである。
条件付き期待値と積率母関数
条件付き期待値
確率過程を研究するには、確率変数の族の相互関係の議論が不可欠である。このとき、条件付き確率と条件付き期待値という基本的な概念とツールを頻繁に使用することになる。本節では関連する概念とツールについて簡単に振り返る。
確率論を学んだ読者は、事象の条件付き確率とは何かを知っているはずである。すなわち、事象Bが起こったという条件の下で事象Aが起こる条件付き確率 $P(A \mid B)$ は $P(A\cap B)/P(B)$ に等しい。しかし、ある確率変数の値が与えられたとき、別の確率変数 $X$ の条件付き期待値とは何であるかは、必ずしも明確に言えないかもしれない。まず、離散型確率変数 $X$ と $Y$ を見てみよう。一般に、$P\{Y=y\}>0$ となるすべての $y$ に対して、与えられた $Y=y$ のときの $X$ がとる条件付き確率を
と定義する。そして、与えられた $Y=y$ のときの $X$ の条件付き分布関数を
と定義する。対応して、与えられた $Y=y$ のときの $X$ の条件付き期待値は
と定義される。
一般の連続型確率変数 $Y$ に対して、$P(Y=y)$ はしばしば0となり、((4))式は無意味になる。我々はどのように条件付き期待値を定義すればよいのだろうか?よく用いられる方法は、$y$ を含む任意の小区間 $\Delta y$ に対して常に $P(Y\in\Delta y)=0$ であれば、$P(X\in A \mid Y=y)=0$ と定義することである。そうでない場合、もし $P(Y\in\Delta y)>0$ であれば、
と定義できる。ここで $\Delta y\downarrow 0$ の表記は、包含する小区間の長さを0に縮小することを表す。個別的な例外の値を除いて、この極限は常に存在する。対応して、与えられた $Y=y$ のときの $X$ の条件付き分布関数を
と定義し、$F(x \mid y)$ と記す。さらに、もし非負関数 $f(x \mid y)$ が存在して、任意の集合 $A$ に対して常に
が成り立つなら、$f(x \mid y)$ を与えられた $Y=y$ のときの $X$ の条件付き密度と呼ぶ。容易にわかるように、条件付き分布関数は条件付き密度を変数 $x$ について $-\infty$ から積分したものである。すなわち
もし $X$ と $Y$ の同時密度 $f(x,y)$ を質量1の平板の密度(面密度)と見なすなら、条件付き密度 $f(x \mid y)$ は $Y=y$ を固定したときの線密度である。それらの間の関係は
である。ここで $f(y)$ は確率変数 $Y$ の周辺密度である。このとき、与えられた $Y=y$ のときの $X$ の条件付き期待値は
と定義される。((6))式と((11))式は本質的に同じことである。もう少し深いコースでは、それらを統一して
と記す。文脈で混同が生じない場合は、$E[X \mid Y]$ と記すことも多い。厳密に言えば、((12))式は($y$ に関連する)一つの数値を表し、$E[X \mid Y]$ は確率変数である。
例1.11 コインを投げて表が出る確率を $p$ とし、独立にコイン投げの試行を行う。$S$ を $n$ 回の試行で表が出た総回数とし、初めて表が出るのは第 $T$ 回目の試行であるとする。問題は、与えられた $n$ 回の試行で表が1回だけ出たという条件下で、確率変数 $T$ の条件付き確率分布を求めること、すなわち $P(T=k \mid S=1)$ を求めることである。
一つの考え方は、表が1回だけ出たという条件が与えられれば、それは $n$ 回の試行のいずれかの回で同じ機会で現れるはずだから、$T$ の条件付き確率分布は $1,2,\dots,n$ 上の一様分布になるはずだというものである。しかし、ある人は次のように反論するかもしれない。「1回だけ表が出たという条件が与えられたなら、それがかなり早い段階で現れる可能性が高いのではないか。実際に計算してみよう。」事象 $\{T=k, S=1\}$ は一つの系列のみを含む。それは第 $k$ 回目の試行でのみ結果が表である場合である。したがって
したがって
前者の見解が正しいことがわかる。
上の例を少し一般化しよう。もし粒子がパラメータ $\lambda$ のポアソン分布に従ってカウンターに入る場合、すなわち $S$ を単位時間区間 $[0,1]$ 上の粒子の総数としたとき、
問題は、$[0,1]$ の時間帯にカウンターに粒子が1個だけ到達したという条件下で、その粒子の到達時間 $T$ はどのような分布に従うかということである。読者は自然に、$[0,1]$ 上の一様分布だと思うだろう。我々は $[0,1]$ 区間を長さ $\Delta t$ の $n$ 個の小区間に分割できる。このとき $\Delta t=\frac{1}{n}$ である。近似的に、$n$ 回の独立試行を行ったのと同じであり、粒子は確率 $\lambda\Delta t$ で各小区間に落ち、その中にない確率は $1-\lambda\Delta t$ である。例1.11より
極限をとれば、与えられた $S=1$ のもとで $T$ は $[0,1]$ 上の一様分布であることがわかる。練習問題1の第10問が別の解法を提供しているので、試してみるとよい。
条件付き期待値にはいくつかの重要な性質があり、以下の命題としてまとめる。
命題 1.1 (a) もし $X$ と $Y$ が独立ならば、$E[X \mid Y=y]=E[X]$。
(b) 条件付き期待値にはいわゆる平滑性がある。
(c) 確率変数 $X, Y$ の関数 $\phi(X,Y)$ に対して常に
が成り立つ。
証明 $X$ と $Y$ が独立であるとき、与えられた $Y=y$ のときの $X$ の条件付き分布と無条件分布は同じであることに注意すれば、(a)はここから容易に証明できる。(b)については離散確率変数の場合のみ証明する。
定義より、$E[X \mid Y=y_{k}] = \sum_{j} x_{j} P(X=x_{j} \mid Y=y_{k})$ であり、右辺は
となる。さらに条件付き確率の定義より、((16))式は先に $k$ について和をとることで
を得る。定義によりまさに $E[X]$ である。(c)の証明は読者の練習問題として残しておく。∎
命題1.1 (b) は、$X$ の期待値を計算する際に2段階を踏むことができると教えている。まず与えられた $Y=y$ のときの $X$ の条件付き期待値を計算し、次にこの条件付き期待値に対して加重平均をとれば全体の平均または期待値となる。これは非常に有用な考え方である。
条件付き期待値は確率統計において極めて重要な概念である。平均二乗誤差最小の基準の下で、$Y$ に基づく $X$ の最適な予測関数 $\phi(\cdot)$ を見つける場合、すなわち $E[X-\phi(Y)]^{2}$ を最小にするものを求める場合、求められる $\phi(y)$ はまさに $E[X \mid Y=y]$ であることが証明できる。これは回帰理論全体の基礎である。
積率母関数および生成関数
命題 1.5 確率変数 $X$ の積率母関数(モーメント母関数)は、確率変数 $\exp\{tX\}$ の期待値として定義され、$g(t)$ と記される。すなわち
積率母関数は確率変数の多くの特徴を記述し、それらの特性を研究するための重要なツールである。積率母関数が存在するとき、それは $X$ の分布を一意に決定する。$g(t)$ を通じて $X$ の各階のモーメントを求めることができる。すなわち、
ここで $g^{(n)}(t)$ は $g(t)$ の $n$ 階導関数の $t$ における値である。積分記号の下で導関数をとることで、容易に((18))式の証明が得られる。互いに独立な確率変数 $X$ と $Y$ に対して、それらの和の積率母関数は、それらの積率母関数の積に等しい。
いくつかの一般的な確率変数分布の積率母関数を暗記しておくことは、異なる確率変数を識別し特徴づけるのに役立つ。巻末の付録表に、一般的な確率変数の分布、積率母関数、平均、および分散を列挙している。
もし確率変数 $Y$ が、独立な確率変数系列 $X_{1}, X_{2}, \dots, X_{N}$ の和であり、かつ添字 $N$ も整数値をとる確率変数である場合、$Y$ は確率変数のランダム和(random sum)と呼ばれる。これは実際の問題でしばしば遭遇する。例えば、$N$ がある時間帯にサービス窓口に到着した顧客の数であり、$X_{i}$ が $i$ 番目の顧客が要求するサービス時間を表すとする。このとき、$Y = \sum_{i=1}^{N}X_{i}$ は総サービス時間を表し、これは待ち行列理論の問題において重要な変数である。また例えば、人口や生物の個体群の成長モデルを議論する際、ある地域におけるある種の生物の総数を $N$、$X_{i}$ を $i$ 番目の個体の子孫の数とすると、$Y$ はその個体群の総数となる。以下では、ランダム和 $Y$ の積率母関数と特性量の計算について議論する。
例1.12 ランダム和の積率母関数。$X_{1}, X_{2}, \dots$ を独立同分布な確率変数の系列とし、$N$ を非負整数値をとる確率変数で、$X$ の系列と独立であるとする。ランダム和 $Y = \sum_{i=1}^{N}X_{i}$ の積率母関数 $g_{Y}(t)$ を求めよ。
解 $g_{Y}$ を求めるため、まず条件付き期待値を計算する。
したがって、$g_{Y}(t) = E[\exp\{tY\}] = E\{E[\exp\{tY\} \mid N]\} = E[(g_{X}(t))^{N}]$ となる。 $g_{Y}(t)$ を $t$ について微分すると、
上式に $t=0$ を代入すると、
もし $\exp\{tX\}$ の期待値を $s^{X}$ の期待値に変更すれば、生成関数または確率母関数を定義できる。
定義 1.6 $X$ が離散型確率変数であるとき、期待値 $E[s^{X}]$ をその確率母関数(probability generating function)と定義し、$\phi_{X}(s)$ と記す。特に、$P(X=k)=p_{k}$($k=0,1,2,\dots$)である場合、$\phi_{X}(s) = \sum_{k=0}^{\infty}p_{k}s^{k}$ となる。
定義より、$\phi_{X}(s)$ は確率 $p_{k}$ を係数とするべき級数である。$\phi_{X}(s)$ と $X$ の確率分布は1対1に対応しており、$p_{0}=\phi_{X}(0)$、さらに
となる。積率母関数の性質と同様に、$X, Y$ が独立な確率変数である場合、それらの和の確率母関数は
となる。また、$X$ の期待値および関連する高次モーメントも、$\phi_{X}(s)$ の $s$ に関する導関数の $s=1$ における値から決定できる。
ランダム和の場合、$X_{i}$ が離散型確率変数であり、その確率母関数が $\phi_{X}(s)$ であるならば、$Y = \sum_{i=1}^{N}X_{i}$ に対して
が成り立つ。すなわち、$Y$ の生成関数は $N$ と $X$ の確率母関数の合成によって構成される。
収束性
確率過程の研究において、さまざまな意味での確率変数列の収束性の問題にしばしば遭遇する。以下では、いくつかの収束性とその間の関係について簡単に紹介する。
定義 1.7 $\{X_{n}, n\ge1\}$ を確率変数の列とする。もし確率変数 $X$ が存在して、任意の $\epsilon>0$ に対して
が成り立つとき、確率変数列 $\{X_{n}, n\ge1\}$ は $X$ に確率収束(convergence in probability)するといい、$X_{n} \xrightarrow{P} X$ と記す。 もし事象 $\{\omega : \lim_{n\rightarrow\infty}(X_{n}(\omega)-X(\omega))=0\}$ の確率が1であるとき、すなわち
であるとき、確率変数列 $\{X_{n}, n\ge1\}$ は $X$ に概収束(almost sure convergence)するといい、$X_{n} \xrightarrow{a.s.} X$ と記す。また、確率変数列が確率1で $X$ に収束するともいう。
例1.13 ベルヌーイ試行において、各試行の成功確率を $p$ とする。$n$ 回の試行における成功回数を $S_{n}$ と記すと、$S_{n}/n \xrightarrow{P} p$ となる。
証明 $S_{n} \sim B(n,p)$ であるため、マルコフの不等式より、任意の $\epsilon>0$ に対して
となる。したがって $S_{n}/n \xrightarrow{P} p$ である。∎
定義 1.8 確率変数 $X$ および $X_{n} \ (n\ge1)$ がすべて有限の2次モーメントを持つとする。もし
であるとき、$X_{n}$ は $X$ に平均二乗収束するといい、$X_{n} \xrightarrow{L_{2}} X$ と記す。 例1.13において、$E[(\frac{S_{n}}{n}-p)^{2}] = \frac{p(1-p)}{n}$ であるため、$S_{n}/n \xrightarrow{L_{2}} p$ となる。
これら3種類の収束性の関係は次の通りである。平均二乗収束および概収束はどちらも確率収束を含意するが、その逆は必ずしも成り立たない。また、平均二乗収束と概収束は互いに包含関係を持たない。
練習問題
1-1 $X(t)$ を2次モーメントが存在する確率過程とする。それが広義定常であるための必要十分条件は、$E[X(s)]$ および $E[X(s)X(s+t)]$ がいずれも $s$ に依存しないことであることを証明せよ。
解. 広義定常過程の定義は,期待値 $E[X(t)]$ が時間に依存せず定数であり,自己相関関数 $R(t_1, t_2) = E[X(t_1)X(t_2)]$ が時間差 $t_2 - t_1$ のみに依存することである.
(必要性) $X(t)$ が広義定常であると仮定する.定義より $E[X(s)]$ は $s$ に依存しない定数である.また,$E[X(s)X(s+t)] = R(s, s+t)$ は,時間差 $(s+t) - s = t$ のみに依存するため,$s$ に依存しない.
(十分性) $E[X(s)]$ と $E[X(s)X(s+t)]$ がいずれも $s$ に依存しないと仮定する.前者の仮定より $E[X(s)]$ は定数である.また,任意の時刻 $t_1, t_2$ に対し,$s = t_1,\ t = t_2 - t_1$ とおくと,
となる.後者の仮定より,これは $t_2 - t_1$ のみに依存する.したがって定義を満たし,$X(t)$ は広義定常である.
2-2 $U_{1},\dots,U_{n}$ を $(0,1)$ 上で一様分布する独立な確率変数とする。$0\le t, x\le 1$ に対して
と定義し、$X(t)=\frac{1}{n}\sum_{k=1}^{n}I(t,U_{k})$ と記す($0\le t\le 1$)。これは $U_{1},\dots,U_{n}$ の経験分布関数である。過程 $X(t)$ の平均関数と共分散関数を求めよ。
解. $I(t, U_k)$ は $U_k \le t$ のとき $1$,そうでないとき $0$ をとる確率変数である.$U_k$ は $(0,1)$ 上の一様分布に従うため,
したがって,平均関数は
次に共分散関数 $C(s,t) = \text{Cov}(X(s), X(t))$ を求める.$U_1, \dots, U_n$ は互いに独立であるため,$k \neq j$ のとき $\text{Cov}(I(s, U_k), I(t, U_j)) = 0$ となる.よって,
ここで,$I(s, U_k)I(t, U_k) = 1$ となるのは $U_k \le s$ かつ $U_k \le t$,すなわち $U_k \le \min(s,t)$ のときであるから,
これより,
ゆえに,求める共分散関数は